

di Tyler Baker* | La prima lezione che imparano gli sviluppatori di Intelligenza Artificiale è che qualsiasi sistema di Intelligenza Artificiale è valido tanto quanto lo è il set di dati su cui è addestrato.
Ecco perché gran parte degli sforzi investiti nello sviluppo di sistemi di Intelligenza Artificiale edge sono dedicati alla gestione del set di dati di addestramento, in modo che fornisca una profondità sufficiente per consentire un apprendimento efficace per il caso d’uso previsto, ma senza creare un modello così grande da non poter essere eseguito da un dispositivo edge valido.
Oggi, questo set di dati per l’addestramento è normalmente generale: un modello per il riconoscimento visivo dei gatti viene addestrato su immagini taggate di gatti tratte dall’archivio internet globale di immagini di gatti. Un produttore di dispositivi non si recherà nei luoghi in cui verrà implementato il suo dispositivo di rilevamento felino per scattare milioni di foto ai gatti locali nelle condizioni di illuminazione del luogo.
Questo approccio all’addestramento dei modelli di Intelligenza Artificiale rappresenta il massimo sforzo dello sviluppatore nel preparare il dispositivo a comprendere il suo ambiente operativo. Questo va bene se bisogna riconoscere un felino. Ma in molte applicazioni AI edge, questo tipo di set di dati di addestramento universale non riesce a fornire al dispositivo le conoscenze necessarie per gestire le specifiche condizioni locali.
L’addestramento AI dall’agricoltura al medicale
Prendiamo l’esempio di un robot autonomo per il diserbo nelle aziende agricole.
La telecamera del robot sarà programmata per riconoscere le immagini delle foglie, per distinguere tra piante coltivate ed erbacce e per trattare le diverse erbe infestanti in modo appropriato. Per ridurre al minimo le dimensioni del modello di riconoscimento delle erbe infestanti, lo sviluppatore lo addestrerà sulle immagini delle erbe più comunemente incontrate dai coltivatori, piuttosto che su un database di tutte le piante del mondo. Questo modello limitato viene poi programmato in tutti i robot da diserbo acquistati dagli agricoltori.
Questo potrebbe funzionare bene finché un’erbaccia sconosciuta non compare nei campi degli agricoltori, magari una specie infestante importata dall’estero. E se un gruppo di agricoltori locali crea una nuova varietà ibrida di una coltura che appare leggermente diversa dalle piante su cui è stato addestrato il modello? In questo caso, il robot potrebbe lasciare crescere un’erbaccia, uccidendo i germogli freschi della pianta coltivata. Lo stesso può valere anche altrove.
Nel campo della medicina, i modelli di monitoraggio della salute personale potrebbero essere addestrati sui dati di persone reclutate per i test, che possono non avere molto denaro ma tanto tempo a disposizione: ad esempio, studenti universitari e altri giovani. I pazienti che trarranno i maggiori benefici dall’utilizzo di un dispositivo AI sanitario potrebbero essere invece quelli della vecchia generazione. In questo caso, i modelli di dati fisiologici che il dispositivo sta tracciando potrebbero non corrispondere in modo ottimale al profilo dell’utente tipico.
Un nuovo approccio all’addestramento AI
Come risolvere quindi il problema del dataset di training generale?
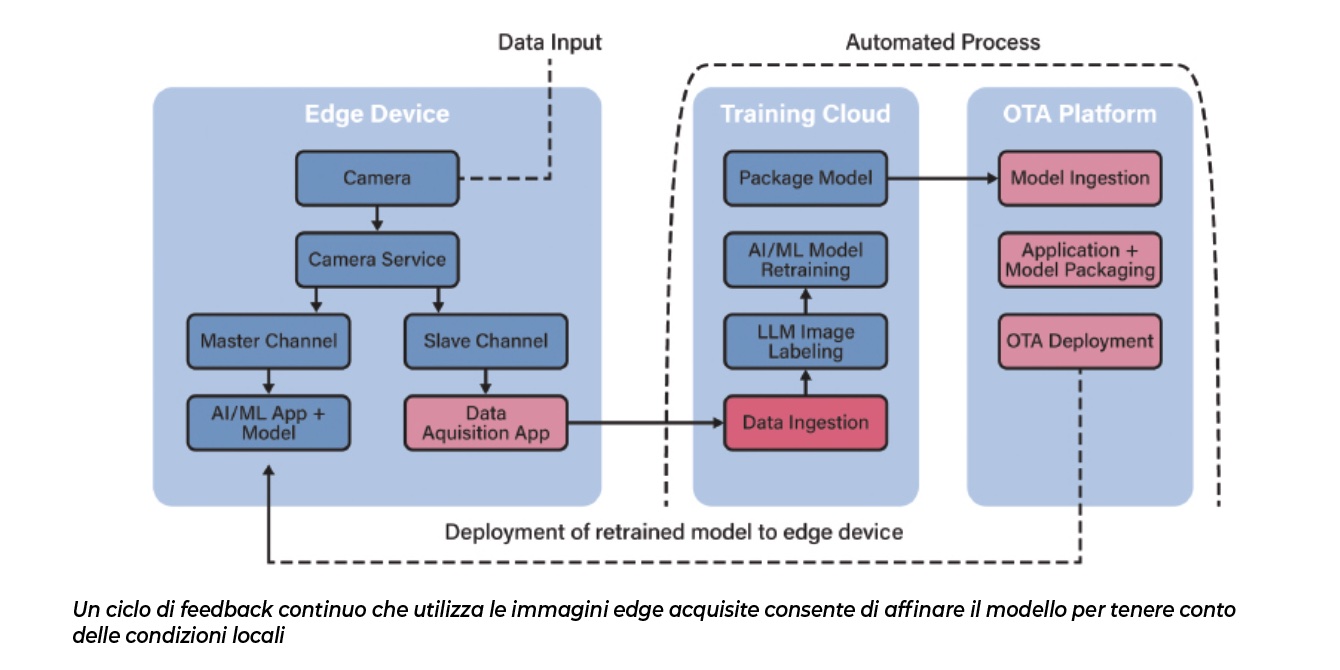
La risposta potrebbe risiedere nell’istituzione di un ciclo di feedback continuo tra il set di dati di addestramento, il sistema di sviluppo del modello nel cloud e i dati acquisiti localmente dai dispositivi installati sul campo.
L’ispirazione per questo approccio in fase di sviluppo da parte degli specialisti di software embedded di Foundries.io e di Edge Impulse è il modello di integrazione continua/sviluppo continuo della distribuzione del software. In questo approccio, i dati (immagini, dati fisiologici ecc.) acquisiti localmente dal dispositivo edge verrebbero utilizzati non solo per alimentare il motore di inferenza, ma anche in parallelo verrebbero raccolti da un processo di acquisizione dati e riportati al dataset di addestramento nel cloud.
Il modello verrebbe addestrato sul nuovo set di dati aumentato o perfezionato, verrebbe generato un nuovo algoritmo di inferenza e questo algoritmo verrebbe distribuito ai dispositivi sul campo, chiudendo il ciclo di feedback. Utilizzando i dati ricavati dall’ambiente individuale di un dispositivo, lo sviluppatore potrebbe migliorare le prestazioni e l’accuratezza del modello, rendendolo più capace di rispondere ai particolari fenomeni osservati localmente.
Dagli aggiornamenti del modello ai dispositivi sul campo
L’implementazione pratica di un tale ciclo di feedback continuo dipende da una grande quantità di automazione del software.
I sistemi Edge Impulse e Foundries.io si integrano bene per questo tipo di funzioni: Edge Impulse fornisce strumenti per l’implementazione di framework AI standard su dispositivi edge; la piattaforma FoundriesFactory, un sistema DevOps per dispositivi embedded, include una toolchain per l’applicazione di funzionalità di sicurezza, il delivery e la distribuzione di aggiornamenti software ai dispositivi sul campo.
L’aggiornamento software over-the-air è oggi considerato quasi esclusivamente un metodo per fornire patch di sicurezza o aggiornamenti di funzionalità a una flotta di dispositivi sul campo. Con la crescente importanza dell’AI nel mondo embedded, questa funzione di aggiornamenti Ota dovrebbe essere ampliata.
In futuro, il processo dovrebbe supportare un ciclo di feedback continuo che consenta di integrare i dataset di addestramento dei dispositivi edge con dati tratti dall’ambiente reale.
* Tyler Baker è VP Engineering, Qualcomm Innovation Center