
In questa intervista a Michaël Uyttersprot, Market Segment Manager for Artificial Intelligence, Machine Learning and Vision in Avnet Silica, ci chiediamo se abbia senso implementare l’AI generativa sui dispositivi integrati e, in tal caso, quali potrebbero essere i potenziali vantaggi.
Con oltre vent’anni di esperienza nel settore, Michael Uyttersprot si sta attualmente concentrando sul supporto allo sviluppo e alla promozione di soluzioni di visione integrata e deep learning per ingegneri impegnati in progetti che coinvolgono AI e machine learning. Da ingegnere robotico a leader di pensiero, ha ottenuto diversi riconoscimenti e la possibilità di presentare le sue ricerche e le sue idee a un vasto pubblico in occasione di eventi di settore internazionali.
Partiamo dalle basi. Che cos’è l’AI generativa e in cosa differisce dall’AI tradizionale?
L’AI generativa consiste nel generare qualcosa di nuovo, qualcosa che prima non esisteva. Sebbene la maggior parte delle persone la conosca attraverso i chatbot, che si concentrano principalmente sulla generazione di contenuti, in particolare di testo, essa può anche trasformare idee in splendide opere d’arte, creare musica originale e scrivere codice. Ciò differisce dallo standard del machine learning o del deep learning, che in genere si concentra sul riconoscimento di modelli o sull’identificazione di oggetti in un’immagine o in un video.
Il passo successivo oltre l’AI generativa è l’agentic AI, ovvero sistemi di AI costituiti da agenti autonomi in grado di prendere decisioni e agire in modo indipendente per raggiungere obiettivi specifici. Questi sistemi possono interagire con il mondo reale e imparare da queste interazioni per migliorare le loro prestazioni.
Cosa sono invece i modelli linguistici di grandi dimensioni?
I Large Language Models sono un tipo specifico di AI generativa utilizzato per generare testo in applicazioni di tipo chatbot. La dimensione del modello linguistico è importante e viene misurata in parametri. Gli Llm distribuiti nel cloud hanno in genere diverse centinaia di miliardi di parametri. Un’idea chiave è quella di avere un Llm memorizzato in un file con cui interagire su un dispositivo embedded, come un file zip. Pertanto, sono necessari Llm più piccoli, talvolta chiamati Small Language Models.
Questi modelli variano da un miliardo a 10 miliardi di parametri. Oltre agli Llm basati su testo, esistono anche Llm multimodali in grado di elaborare e comprendere informazioni provenienti da vari altri tipi di dati, o “modalità”, come immagini, audio e video. Questi modelli generano output che consentono una maggiore comprensione e risposte più dettagliate.
Quali sono i vantaggi dell’esecuzione locale degli Llm su dispositivi embedded?
L’esecuzione dell’AI generativa a livello locale su dispositivi integrati offre diversi vantaggi rispetto all’utilizzo di servizi cloud come ChatGpt. Innanzitutto, non è necessario disporre di una connessione Internet, oppure è possibile scegliere di non averla, riducendo così la latenza rispetto all’esecuzione sul cloud.
Anche la privacy dei dati è un punto fondamentale: alcune ricerche hanno rilevato che una percentuale significativa di persone pone domande riservate sui chatbot. L’esecuzione in locale consente di proteggere e mantenere questi dati sul dispositivo. Inoltre, se è possibile eseguire il modello in locale con Llm open source e gratuiti, non c’è alcun costo aggiuntivo.
Quali sono le sfide o i vincoli nell’implementazione degli Llm su dispositivi embedded?
L’esecuzione di Llm su dispositivi integrati è piuttosto complessa. Come accennato in precedenza, gli Llm più grandi che funzionano nel cloud sono troppo grandi; pertanto, sono necessari modelli più piccoli. Tuttavia, fino a pochi anni fa non era possibile memorizzare contenuti in un file di piccole dimensioni su un dispositivo embedded. I dispositivi integrati avevano una Ram limitata (4 o 8 GB), avevano anche restrizioni sulla potenza di elaborazione e potevano non disporre di una Gpu.
Il che non è l’ideale per le applicazioni in tempo reale, poiché l’utente non vuole aspettare minuti dopo aver fornito un prompt di testo. Alcuni sistemi embedded potrebbero non eseguire Linux o Windows, il che presenta delle sfide di integrazione. Anche i driver possono essere un problema. Infine, anche il consumo energetico potrebbe rappresentare una limitazione, soprattutto per i dispositivi alimentati a batteria.
Ci può fare qualche esempio di caso o applicazione dell’AI generativa locale su dispositivi embedded?
Abbiamo dimostrato l’AI generativa in esecuzione su un dispositivo integrato con un’implementazione ispirata alla funzione podcast Notebook di Google, in cui due avatar (un conduttore e un esperto) conversano su un argomento prestabilito come l’AI generativa. Un utente umano può anche interrompere e porre domande. Il contenuto e le domande specifiche generate sono sempre diversi proprio per via della natura generativa dell’AI.
Oltre a questa dimostrazione, sono possibili numerosi altri casi d’uso, che spaziano dalla domotica alla vendita al dettaglio. Un buon esempio che viene in mente è un sistema di conferenza in grado di catturare il parlato, guidare le riunioni, prendere appunti e persino tradurre diverse lingue in tempo reale. In un ambiente industriale, impartire comandi vocali o porre domande a macchine o cobot può essere un approccio efficace.
Che tipo di hardware viene utilizzato per queste implementazioni?
Nella nostra indagine sull’esecuzione di modelli di AI generativa su dispositivi integrati, abbiamo utilizzato un pacchetto ASRock. Questo box contiene un processore Amd Ryzen 8000 con Gpu integrata e una specifica Neural Processing Unit basata su AI Engine XDNA (anche se in questo caso l’Npu non è stata utilizzata).
Il sistema dispone inoltre di Ram, Ssd e sistema operativo Windows IoT. Altri hardware testati o in fase di test includono dispositivi Nxp i.MX 95, Renesas RV2H e Qualcomm. A seconda dell’hardware scelto, è necessario trovare un compromesso tra le capacità hardware, la memoria e la potenza di elaborazione, nonché le dimensioni e la qualità dell’SLM che può essere eseguito.
Quali sono gli strumenti core per sviluppare tali applicazioni su dispositivi embedded?
L’architettura del software comprende un front-end (un’interfaccia web) e un server back-end scritto in Python, composto da questi tre componenti:
• Motore Speech-to-text – Per comprendere ciò che dice un essere umano e convertirlo in testo. Il modello Whisper di OpenAI è un modello locale molto diffuso, disponibile in varie dimensioni (tiny, base, small, medium), ciascuna con compromessi distinti in termini di risorse e velocità. Include funzionalità come la riduzione del rumore. Per il confronto è stata utilizzata un’opzione cloud di Google (una libreria di riconoscimento vocale).
• Grandi Modelli Linguistici (Large Language Models) – Abbiamo utilizzato strumenti che consentono di caricare modelli da fonti come Hugging Face per generare risposte testuali. Gemma 2 (2 miliardi di parametri) si è rivelato piuttosto impressionante, riuscendo a funzionare con soli 2 GB di Ram. È stato testato anche un modello da 9 miliardi di parametri, evidenziando una differenza nella complessità delle parole rispetto ai modelli più piccoli. Altri SLM che possono essere testati includono Phi di Microsoft e Mistral di Mistral AI, tra gli altri. Per confronto, nelle nostre analisi sono stati utilizzati modelli cloud come Llama (Meta AI), ChatGpt (OpenAI) e Claude (Anthropic).
• Motore Text-to-Speech – Per convertire il testo generato in linguaggio parlato. È stato utilizzato Piper (motore Tts di Rhasspy) per l’implementazione locale, con supporto per 30 lingue diverse. Per una qualità superiore, è stato impiegato il servizio cloud ElevenLabs. Sebbene la qualità di Piper in locale fosse buona, mancava della naturalezza offerta da ElevenLabs. Tuttavia, sono attesi presto miglioramenti nella qualità del text-to-speech locale.
Per concludere, quali sono i vantaggi e come Avnet Silica supporta i propri partner?
L’implementazione dell’AI generativa e degli Llm su dispositivi integrati è fattibile e offre vantaggi significativi quali una maggiore privacy dei dati, costi ridotti e una minore latenza. Pur richiedendo un’ottimizzazione per risolvere vincoli quali Ram e potenza di elaborazione limitate, modelli più piccoli e hardware specializzato rendono possibile l’implementazione locale. Ciò consente diverse applicazioni, dall’AI conversazionale alle interazioni industriali, segnando un futuro promettente in un’ottica di “AI ovunque”.
Avnet Silica si è affermata nelle soluzioni Edge AI offrendo un solido ecosistema di hardware, software e supporto tecnico progettato per soddisfare le esigenze dei settori che richiedono un’elaborazione AI localizzata e in tempo reale. L’obiettivo è fornire alle aziende gli strumenti per integrare perfettamente l’Edge AI nelle loro operazioni, garantendo prestazioni, adattabilità ed efficienza e riducendo al contempo la dipendenza dai sistemi basati su cloud.
La potenza di un chatbot avanzato basato su Edge
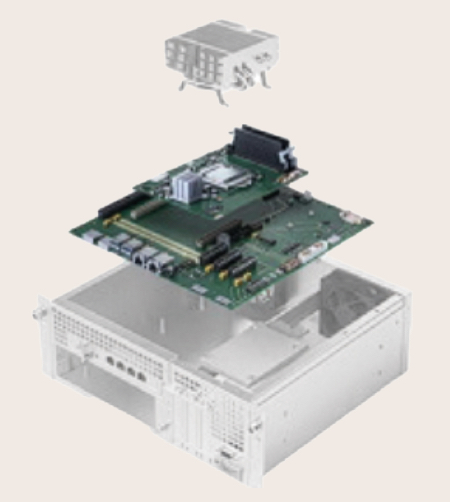 Una delle innovazioni di punta nell’Edge AI è la soluzione Edge Gen AI Phone Box. Questo chatbot vocale basato sull’Intelligenza Artificiale dimostra l’efficacia dell’elaborazione AI localizzata e in tempo reale.
Alimentato da un Llm locale da 9 miliardi di parametri e perfettamente integrato nei sistemi embedded Tria, fornisce risposte rapide e a bassa latenza garantendo al contempo una maggiore privacy.
Questa soluzione apre la strada a esperienze innovative, dimostrando come l’Intelligenza Artificiale embedded possa aumentare l’efficienza, migliorare le interazioni con i clienti e fornire automazione in vari settori senza fare affidamento sull’infrastruttura cloud.